TensorRT 与 ONNX Runtime 推理全解析
摘要
大模型从训练好的权重变成能对外提供服务的产品,中间必须经过“推理引擎”这一关。TensorRT(及其大模型分支 TensorRT-LLM)和 ONNX Runtime(及其生成式扩展 ONNX Runtime GenAI)是目前工程落地中最常被提到的两套推理方案,一个主打 NVIDIA GPU 上的极致性能,一个主打跨硬件、跨平台的通用部署。理解这两者的定位差异和使用方法,是做大模型推理绕不开的基础知识。
背景与问题
一个训练好的大模型直接用 PyTorch 跑推理,往往达不到生产环境要求的吞吐和延迟:显存占用高、算子没有针对硬件做融合优化、批处理调度粗放,GPU 利用率常常上不去。于是就出现了专门的推理引擎层,它们在模型权重之上做算子融合、低精度量化、批处理调度和内存管理,把同样的模型跑得更快、更省资源。
TensorRT 和 ONNX Runtime 是这条链路上最主流的两个选择,但它们的出发点完全不同:TensorRT 是 NVIDIA 深度绑定自家 GPU 硬件的优化引擎,ONNX Runtime 则是微软主导、面向多硬件后端的通用推理运行时。很多团队在选型时会纠结“到底该用哪个”,实际上二者在大部分生产架构里并不是互斥关系,而是分别覆盖不同的部署场景。
核心思路与优势
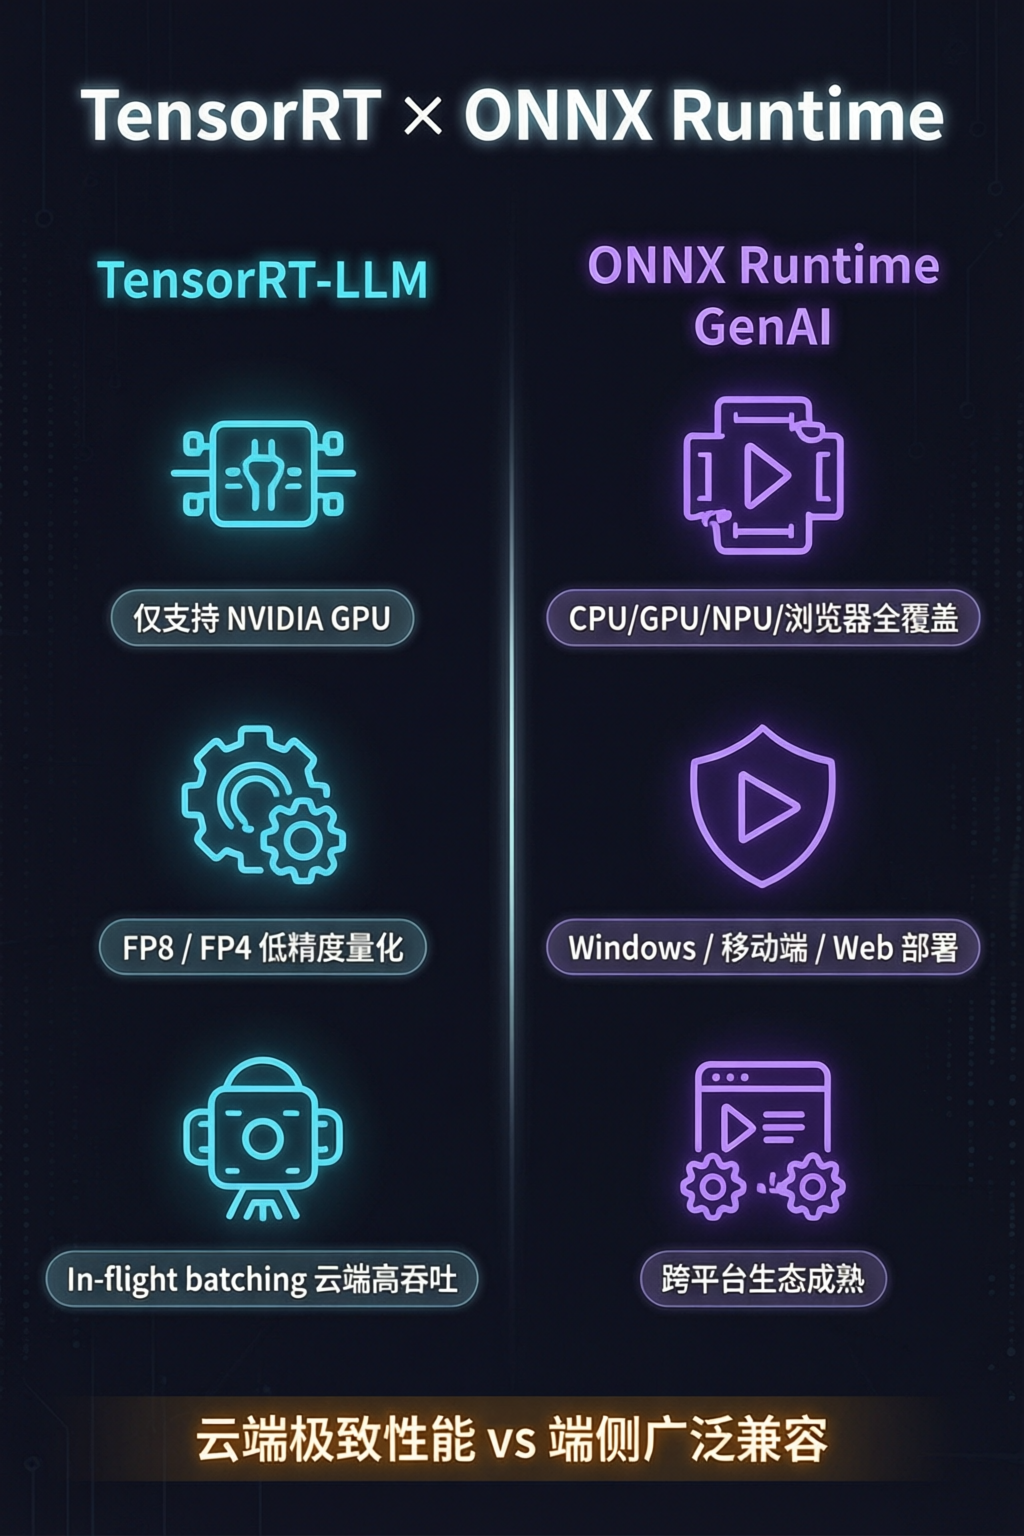
TensorRT / TensorRT-LLM 的核心思路是“只服务 NVIDIA GPU,把优化做到极致”。TensorRT-LLM 基于 PyTorch 构建,提供高层 Python LLM API,可以从单卡一路扩展到多卡、多机部署,并能与 Triton Inference Server、NVIDIA Dynamo 等服务框架集成。它的主要优势集中在这几点:
- 低精度量化:H100 及更新架构支持 FP8 自动转换,吞吐量最高提升一倍、显存占用减半;B200 上原生支持 FP4,配套专门优化的 kernel;此外还支持 INT4/AWQ 等量化方案。
- In-flight batching + Paged Attention:把不同请求的 context 阶段和 generation 阶段动态编排在一起处理,显著提升 GPU 利用率、降低排队等待时间。
- 投机采样(Speculative Decoding):支持 EAGLE、MTP、N-Gram 等算法,用小模型或历史信息预测后续 token,减少大模型的实际解码步数。
- 多卡并行:tensor parallelism、pipeline parallelism,以及面向 MoE 模型的 expert parallelism。
- Paged KV Cache:支持显存块的智能复用,降低长上下文场景下的显存开销。
ONNX Runtime / ONNX Runtime GenAI 的核心思路则是“一份模型,尽可能多硬件都能跑”。ONNX Runtime 本身是跨平台推理引擎,通过 Execution Provider 机制适配不同硬件后端;ONNX Runtime GenAI 在此基础上补齐了生成式模型专用的推理循环——预处理/后处理、logits 处理、greedy/beam search、采样、重复惩罚、KV Cache 管理,以及面向工具调用场景的 grammar 约束解码。它的优势在于:
- 硬件覆盖面广:同时支持 CPU、CUDA、DirectML、OpenVINO、QNN(高通 NPU)、WebGPU,乃至面向消费级显卡的 TensorRT-RTX 后端。
- 平台覆盖面广:Linux、Windows、macOS、Android、iOS、WebAssembly(浏览器端)均可运行,是目前 Windows 本地应用、移动端、边缘设备部署 AI 模型的事实标准之一。
- 模型生态成熟:Llama、Phi、Mistral、Gemma、Qwen、DeepSeek、ChatGLM、Whisper 等主流开源模型都有现成支持;Hugging Face 上已经积累了大量预量化好的 ONNX 模型,下载后可以直接运行,不需要自己做格式转换。
- 算子覆盖更全:不像 TensorRT 遇到冷门算子(比如 scatter_add)有时需要手写插件,ONNX Runtime 对大多数算子都有原生实现,减少了工程适配成本。
面向人群
- 正在把大模型从训练环境搬到生产环境的算法工程师和后端工程师,需要为服务选择合适的推理引擎。
- 负责云端 GPU 集群推理服务性能优化的基础设施/MLOps 工程师。
- 需要把模型部署到 Windows 桌面应用、移动端 App 或浏览器端的端侧 AI 开发者。
- 准备大模型推理相关技术面试、需要系统梳理推理框架知识体系的求职者。
实践步骤
用 TensorRT-LLM 跑一个模型
TensorRT-LLM 提供了高层的 LLM API,几行代码就能完成加载和生成:
from tensorrt_llm import LLM, SamplingParams

def main():
    llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0")

    prompts = [
        "Hello, my name is",
        "The capital of France is",
        "The future of AI is",
    ]

    sampling_params = SamplingParams(temperature=0.8, top_p=0.95)

    for output in llm.generate(prompts, sampling_params):
        print(f"Prompt: {output.prompt!r}, Generated text: {output.outputs[0].text!r}")

if __name__ == "__main__":
    main()
这里的 model 参数既可以是 HuggingFace 上的模型名,也可以是本地模型路径,或者是经过 Model Optimizer 量化处理后的 checkpoint。SamplingParams 用来控制温度、top_p 等采样参数。真实生产环境中,还需要根据显卡型号和显存大小选择合适的量化精度(FP8/FP4/INT4),并开启 in-flight batching 来提升并发吞吐。
用 ONNX Runtime GenAI 跑一个模型
ONNX Runtime GenAI 的调用方式更接近手动控制生成循环,适合需要精细定制的场景:
import onnxruntime_genai as og

model = og.Model('model_path')
tokenizer = og.Tokenizer(model)

search_options = {'max_length': 2048, 'batch_size': 1}
params = og.GeneratorParams(model)
params.set_search_options(**search_options)

input_tokens = tokenizer.encode("Your prompt here")
generator = og.Generator(model, params)
generator.append_tokens(input_tokens)

while not generator.is_done():
    generator.generate_next_token()
model_path 指向的是转换成 ONNX 格式(通常已经量化好)的模型目录。整个生成过程是显式的 while 循环,每一步都可以插入自定义的 logits 处理逻辑,这也是它比“黑盒式”高层 API 更适合做深度定制的原因。ONNX Runtime GenAI 还提供 C#、C/C++、Java 等多语言 API,方便集成进 Windows 桌面应用或移动端 App。
两者怎么选
一个常见的生产实践是按部署环境分流:云端 GPU 集群、大批量高并发请求,优先用 TensorRT-LLM 追求极致吞吐和低延迟;CPU、端侧设备、浏览器或碎片化的小批量请求,用 ONNX Runtime 保证跨硬件的覆盖率和可移植性。二者甚至可以出现在同一套服务架构里:核心云端服务用 TensorRT-LLM,客户端本地推理或离线场景用 ONNX Runtime GenAI,互为补充而非互相替代。
对比总结
| 维度 | TensorRT / TensorRT-LLM | ONNX Runtime / ONNX Runtime GenAI |
|---|---|---|
| 硬件支持 | 仅 NVIDIA GPU | CPU、CUDA、DirectML、OpenVINO、QNN、WebGPU 等多后端 |
| 平台支持 | 主要面向云端/数据中心 Linux 服务器,Windows 仅有限支持 | Linux、Windows、macOS、Android、iOS、WebAssembly 全覆盖 |
| 性能特点 | 深度绑定硬件做算子融合与低精度优化,吞吐和显存效率通常更高 | 通用性优先,性能依赖具体 Execution Provider 的实现质量 |
| 算子覆盖 | 冷门算子有时需要手写插件 | 覆盖更全,较少需要自定义实现 |
| 典型场景 | 云端大批量高并发推理服务 | 端侧、跨平台、离线场景 |
应用领域
TensorRT-LLM 主要活跃在云端大模型推理服务领域,通常与 Triton Inference Server、NVIDIA Dynamo 等组件配合,支撑在线聊天机器人、Agent 服务、批量文本生成等对吞吐和延迟要求较高的 GPU 集群场景。ONNX Runtime 和 ONNX Runtime GenAI 则更多出现在端侧和跨平台场景中:Windows 本地应用、Android/iOS 移动端功能、浏览器端 WebAssembly 推理,以及骁龙 NPU、Intel Core Ultra 处理器上的边缘设备智能——这类场景通常更看重离线可用性、隐私保护和多硬件兼容性,而不是极致的单卡吞吐。
对于任何要落地大模型推理服务的团队来说,把这两套工具的定位、优势和适用边界搞清楚,是绕不开的基础功课。